“Sencillamente magnífico!! Lograron no solo cumplir, sino realzar nuestro proyecto con ideas innovadoras y una ejecución impecable. Este logro ha sido fundamental para nuestro éxito empresarial reciente. Un equipo profes…”
Cliente verificado

IA ON-PREMISE
Implantem models de llenguatge a la teva pròpia infraestructura per reduir cost per token i mantenir les dades dins de la teva organització, amb el sizing de maquinari i l'stack d'inferència adequats.
Un LLM on-premise té sentit quan necessites executar models de llenguatge al teu propi maquinari per seguretat o cost, no una solució al núvol d'un tercer. Abans de triar eines, definim els recorreguts, les dades i les decisions que han de quedar sota el control de la teva empresa.
Treballem des de Barcelona i Madrid i en remot amb equips d'Espanya, Europa, Llatinoamèrica i els Estats Units. El procés combina reunions de decisió, entregues verificables i documentació perquè l'avenç sigui visible.
Entreguem codi, repositoris, configuracions i documentació en comptes de la teva empresa. Així pots auditar, evolucionar o canviar de proveïdor sense dependre d'accessos privats ni llicències.
Implantem models de llenguatge a la teva pròpia infraestructura per reduir cost per token i mantenir les dades dins de la teva organització, amb el sizing de maquinari i l'stack d'inferència adequats. Per això prioritzem una solució mantenible, mesurable i preparada per evolucionar sense refer la base.
EL REPTE
la privacitat i el cost per token empenyen a executar IA local
Enviar informació sensible a models al núvol incompleix polítiques internes o normatives sectorials.
Executar un LLM propi exigeix dimensionar GPU, memòria i emmagatzematge sense pagar de més.
Un model intern ha de controlar què respon, a qui i amb quines dades, de manera auditable.
ENFOCAMENT
Avancem amb decisions mesurables i lliuraments que ja aporten valor.
Definim quins casos d'ús, volum i nivell de confidencialitat ha de suportar el model local.
Dimensionem maquinari i programari per servir el model amb latència i cost acceptables.
Instal·lem i afinem el LLM sobre les vostres dades, amb revisió humana de les respostes.
Establim regles d'accés, actualització de versions i monitoratge continu.
LLIURABLES
Entreguem una base operativa que el teu equip pot governar i seguir millorant.
Model desplegat a la vostra infraestructura i disponible per als usuaris autoritzats.
Configuració de maquinari i programari documentada i ajustada a la càrrega real.
Regles de permisos, dades permeses i excepcions definides i traçables.
Pautes per mantenir el model al dia i controlar-ne el rendiment i la seguretat.
CONFIANÇA
Dimensionem GPU (NVIDIA/AMD) i operem el cicle complet: model, inferència i integració amb processos reals.
Dubtes
Explica'ns què necessites sobre LLM on-premise per a empreses. T'ajudarem a convertir-ho en un pla viable i clar.
Lo que dicen empresas que ya trabajan con nosotros
PROYECTOS DESTACADOS
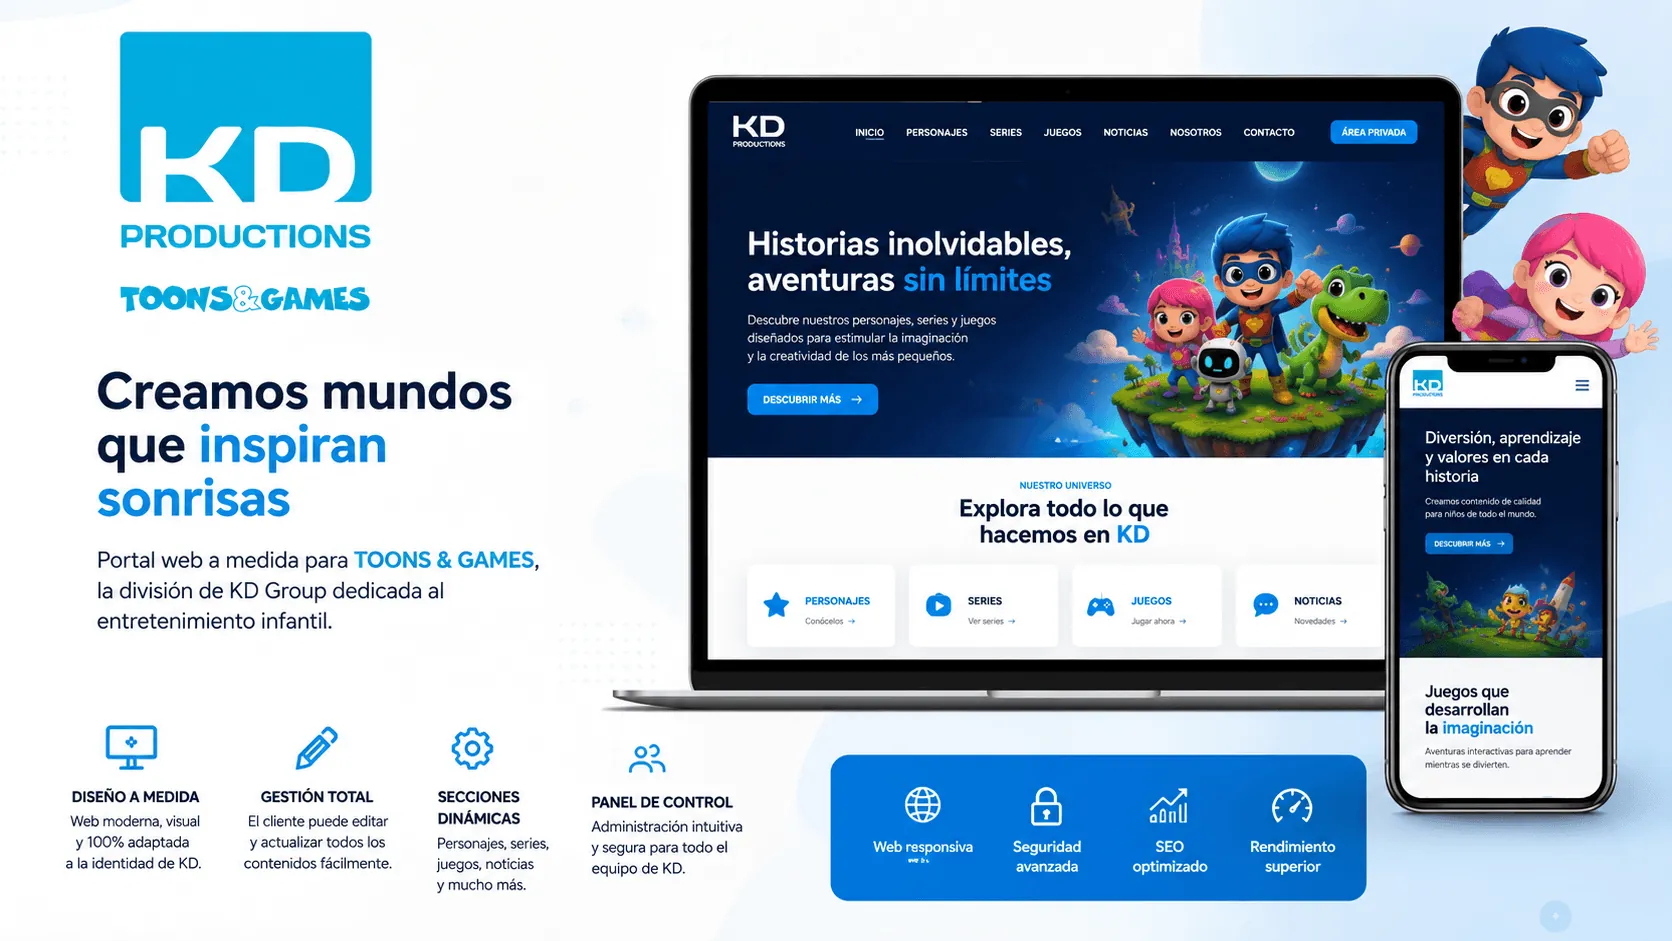 Desenvolupament+4
Web corporativa +1
Sector · Mitjana i entreteniment
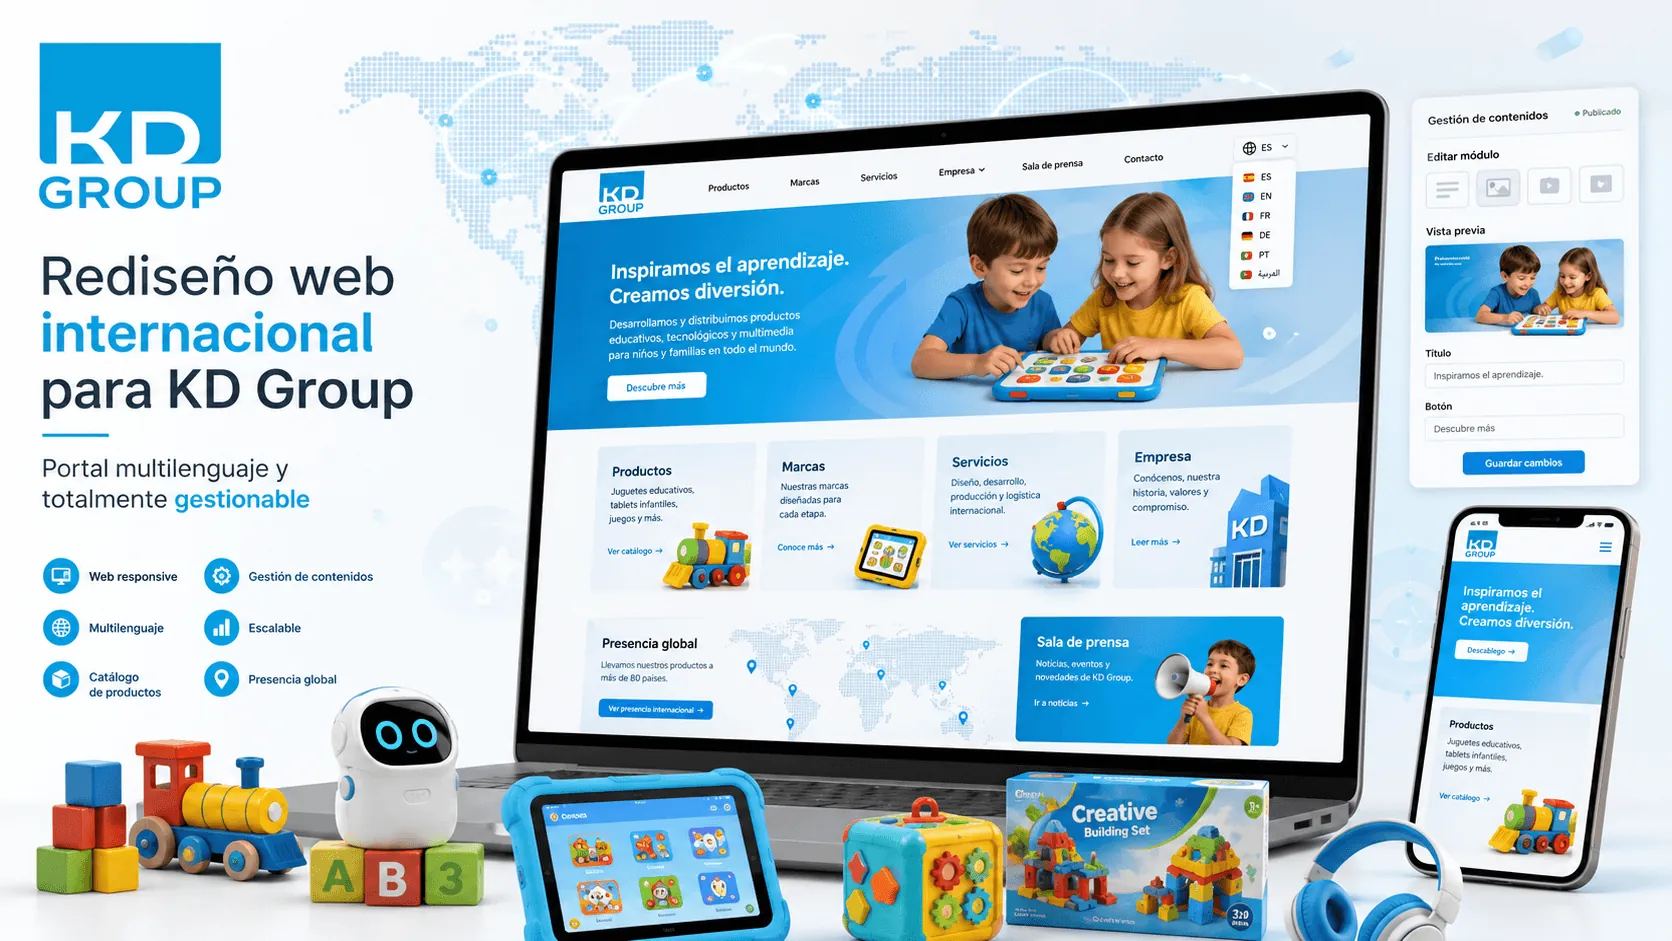 Desenvolupament+6
Web corporativa +2
Sector · Educació i EdTech
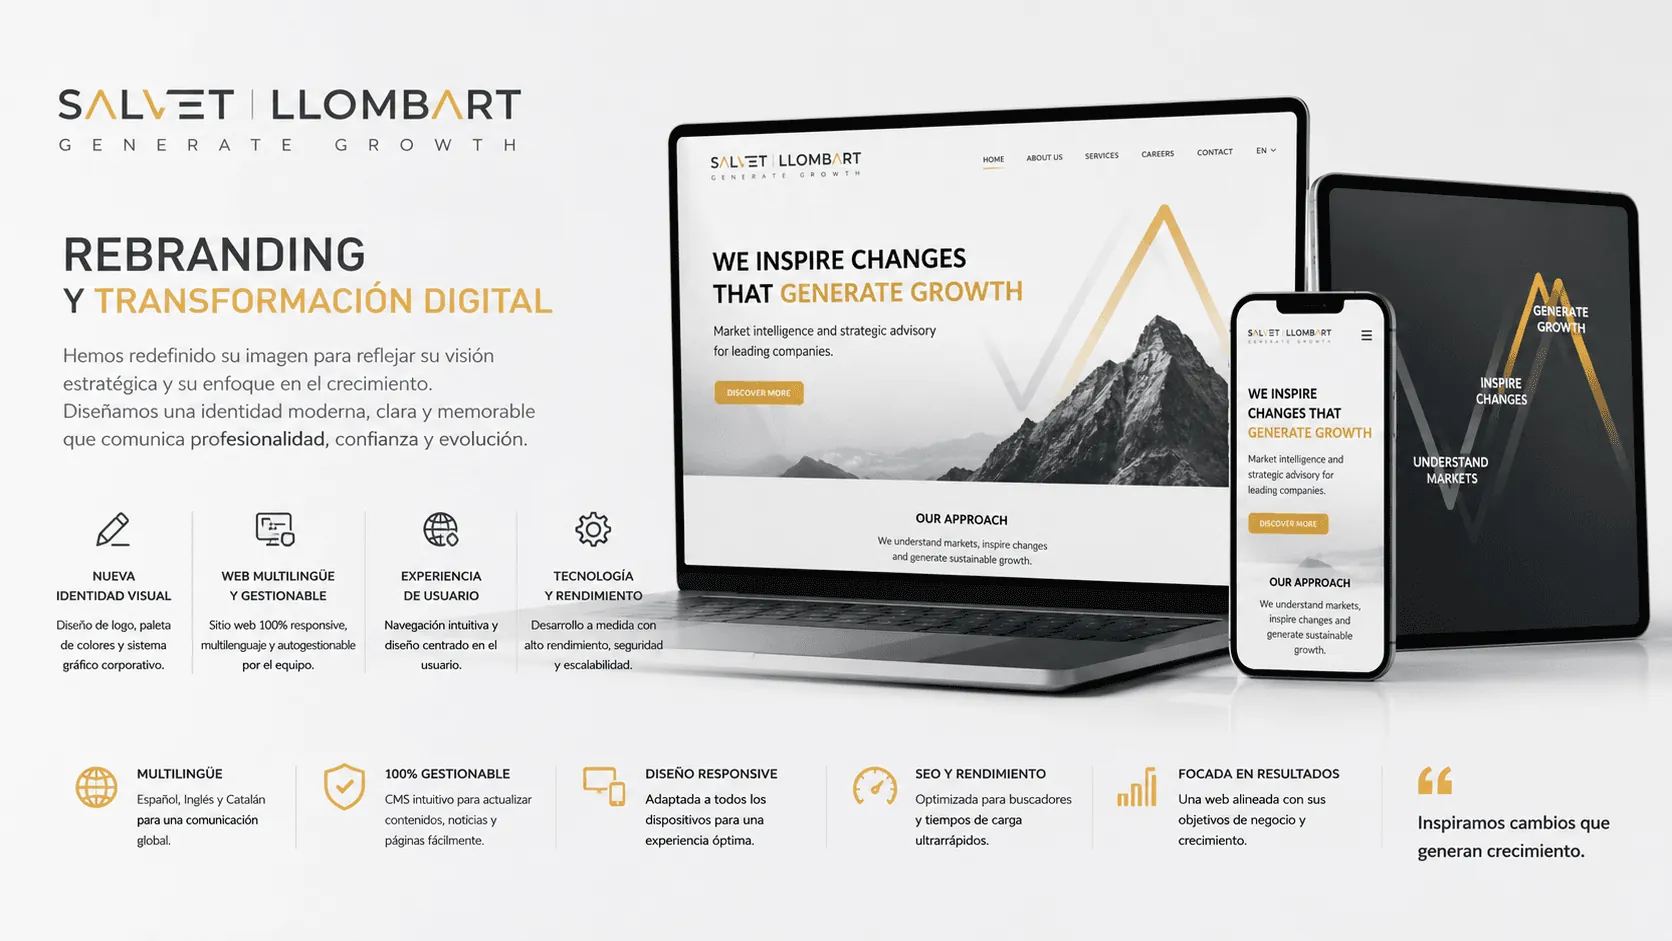 Desenvolupament+2
Web corporativa +3
Sector · Educació i EdTech