“Sencillamente magnífico!! Lograron no solo cumplir, sino realzar nuestro proyecto con ideas innovadoras y una ejecución impecable. Este logro ha sido fundamental para nuestro éxito empresarial reciente. Un equipo profes…”
Cliente verificado

IA ON-PREMISE
Implantamos modelos de lenguaje en tu propia infraestructura para reducir coste por token y mantener los datos dentro de tu organización, con el sizing de hardware y el stack de inferencia adecuados.
Un LLM on-premise tiene sentido cuando necesitas ejecutar modelos de lenguaje en tu propio hardware por seguridad o coste, no una solución en la nube de un tercero. Antes de elegir herramientas, definimos los recorridos, los datos y las decisiones que deben quedar bajo control de tu empresa.
Trabajamos desde Barcelona y Madrid y en remoto con equipos de España, Europa, LATAM y Estados Unidos. El proceso combina reuniones de decisión, entregas verificables y documentación para que el avance sea visible.
Entregamos código, repositorios, configuraciones y documentación en cuentas de tu empresa. Así puedes auditar, evolucionar o cambiar de proveedor sin depender de licencias o accesos privados.
Implantamos modelos de lenguaje en tu propia infraestructura para reducir coste por token y mantener los datos dentro de tu organización, con el sizing de hardware y el stack de inferencia adecuados. Por eso priorizamos una solución mantenible, medible y preparada para evolucionar sin rehacer la base.
EL RETO
la privacidad y el coste por token empujan a ejecutar IA local
Enviar información sensible a modelos en la nube incumple políticas internas o normativas sectoriales.
Ejecutar un LLM propio exige dimensionar GPU, memoria y almacenamiento sin pagar de más.
Un modelo interno debe controlar qué responde, a quién y con qué datos, de forma auditable.
ENFOQUE
Avanzamos con decisiones medibles y entregas que ya aportan valor.
Definimos qué casos de uso, volumen y nivel de confidencialidad debe soportar el modelo local.
Dimensionamos hardware y software para servir el modelo con latencia y coste aceptables.
Instalamos y afinamos el LLM sobre vuestros datos, con revisión humana de las respuestas.
Establecemos reglas de acceso, actualización de versiones y monitorización continua.
ENTREGABLES
Entregamos una base operativa que tu equipo puede gobernar y seguir mejorando.
Modelo desplegado en vuestra infraestructura y disponible para los usuarios autorizados.
Configuración de hardware y software documentada y ajustada a la carga real.
Reglas de permisos, datos permitidos y excepciones definidas y trazables.
Pautas para mantener el modelo al día y controlar su rendimiento y seguridad.
CONFIANZA
Dimensionamos GPU (NVIDIA/AMD) y operamos el ciclo completo: modelo, inferencia e integración con procesos reales.
Dudas frecuentes
Cuéntanos qué necesitas sobre LLM on-premise para empresas. Te ayudaremos a convertirlo en un plan claro, viable y ejecutable.
Lo que dicen empresas que ya trabajan con nosotros
PROYECTOS DESTACADOS
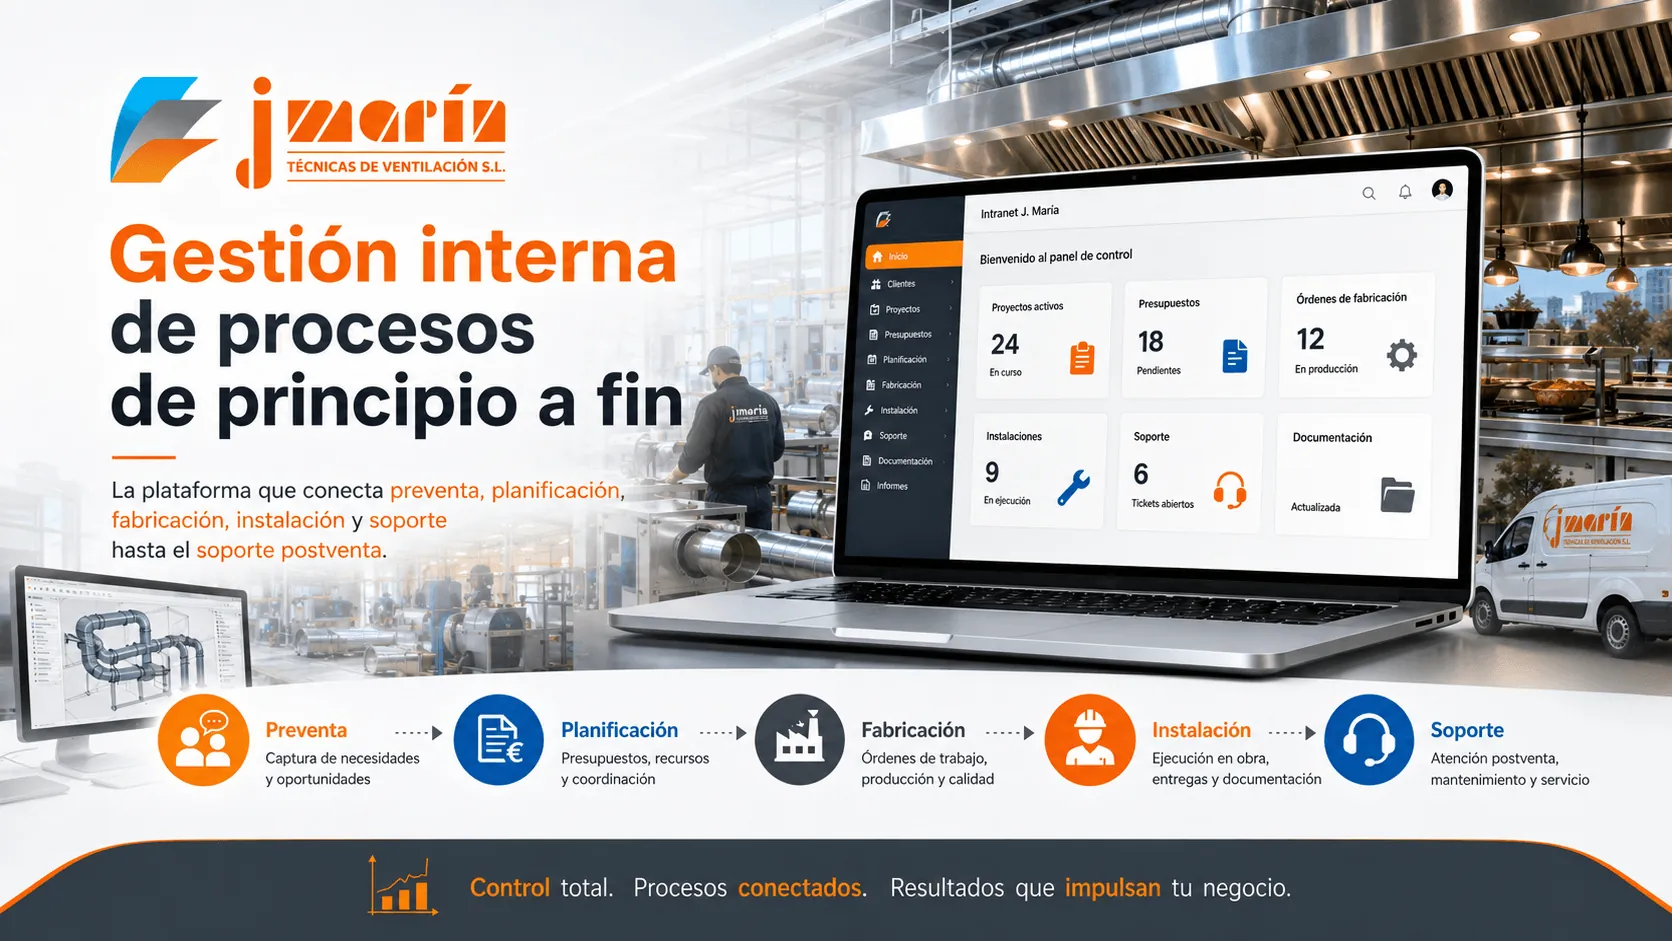 Desarrollo+6
Portal / intranet
Sector · Industria y manufactura
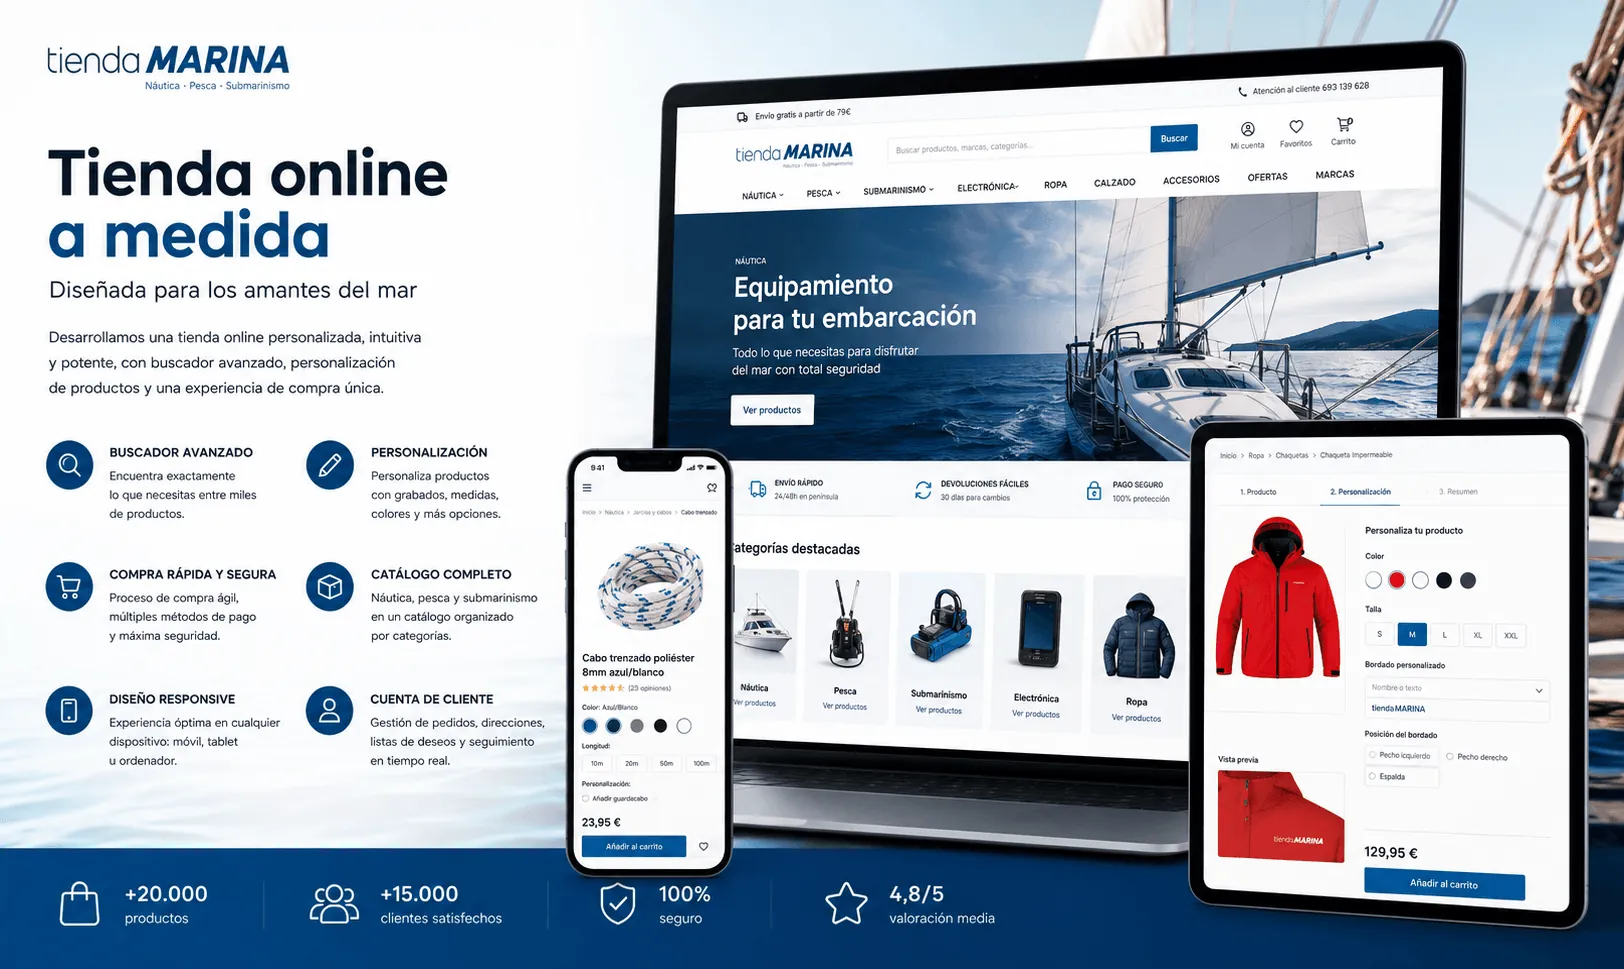 Desarrollo+5
E-commerce / tienda online +2
Sector · Inmobiliario y PropTech
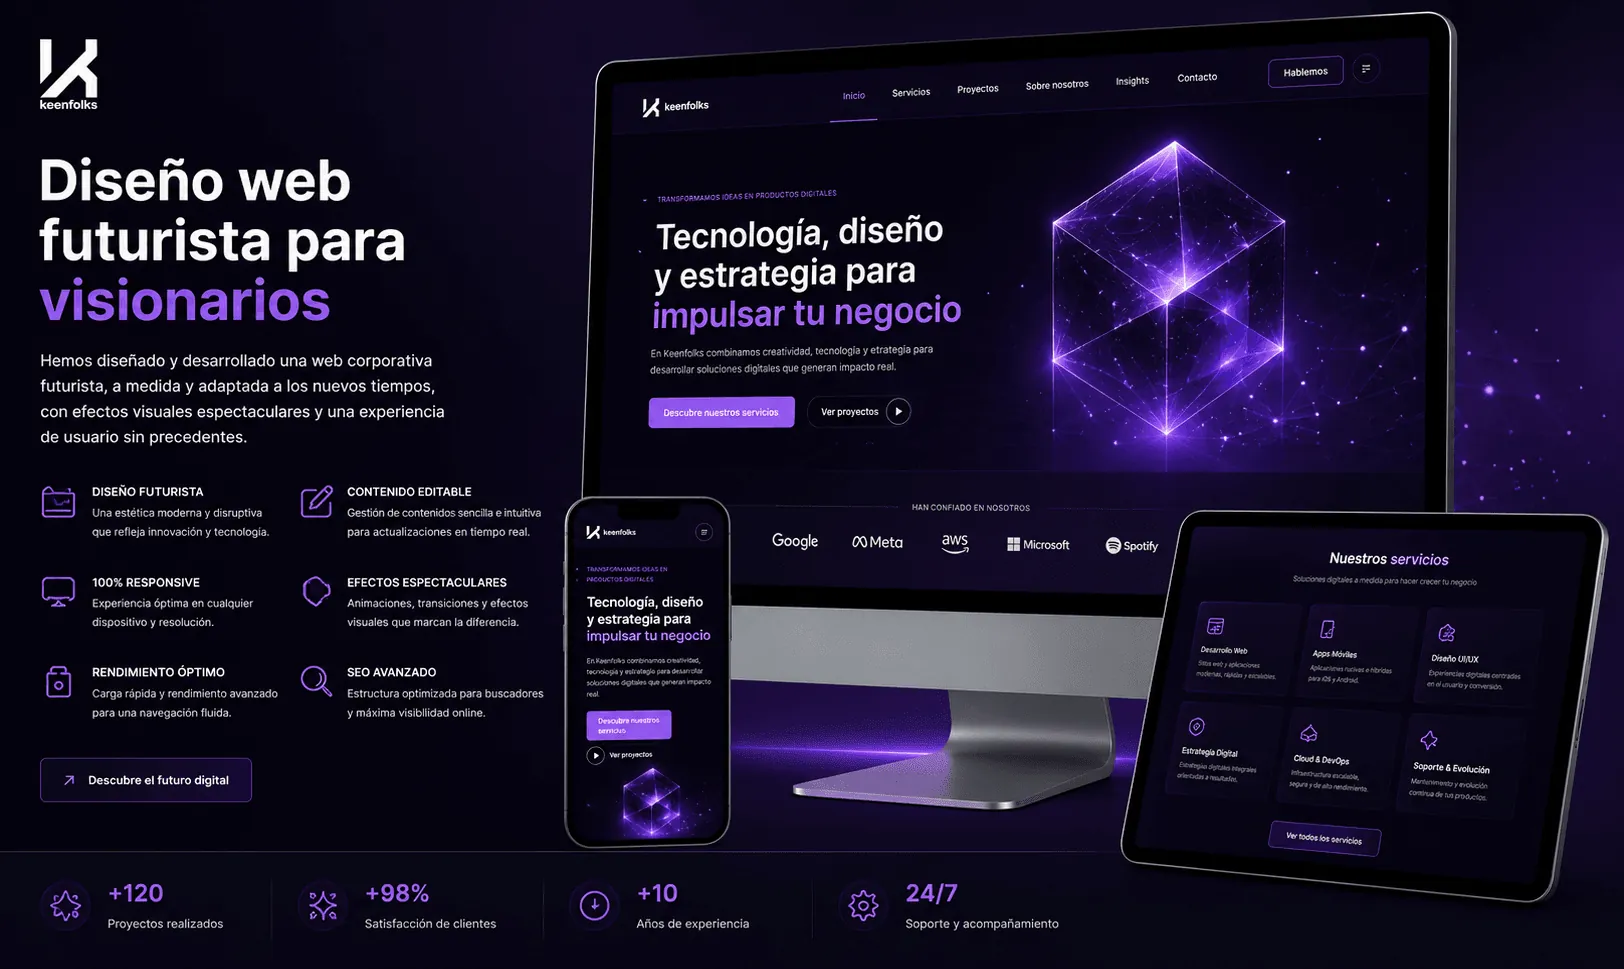 Desarrollo+4
Web corporativa +3
Sector · Marketing y publicidad